当前,人工智能(AI)正由算法驱动向数据驱动加速演进。当算法架构逐步趋同、算力资源不断普惠,数据,尤其是高质量、高价值密度的医疗数据,日益成为决定医疗AI模型能力上限的核心要素。与此同时,在各类政策文件、技术标准与新闻报道中,原始数据、数据资源、数据资产、数据要素、数据产品、高质量数据集等名词频繁出现,它们的概念彼此之间相互关联,但内涵与边界又有所不同。
一份医院信息系统的病历,在合规治理、权属确认、价值释放的全过程中,会不断迭代出新的身份,承担新的不同的职责。对于医疗机构、AI企业及数据服务商而言,厘清这些身份名词的真正含义,不仅是读懂政策文件的基础,更是开展数据集建设、数据流通与价值落地工作的必备前提。
本文结合国家数据局《数据领域常用名词解释(第一批)》及《高质量数据集 建设指南(征求意见稿)》(注:已正式发布实施)中的官方定义,立足医疗场景,系统拆解医疗数据的六重身份。
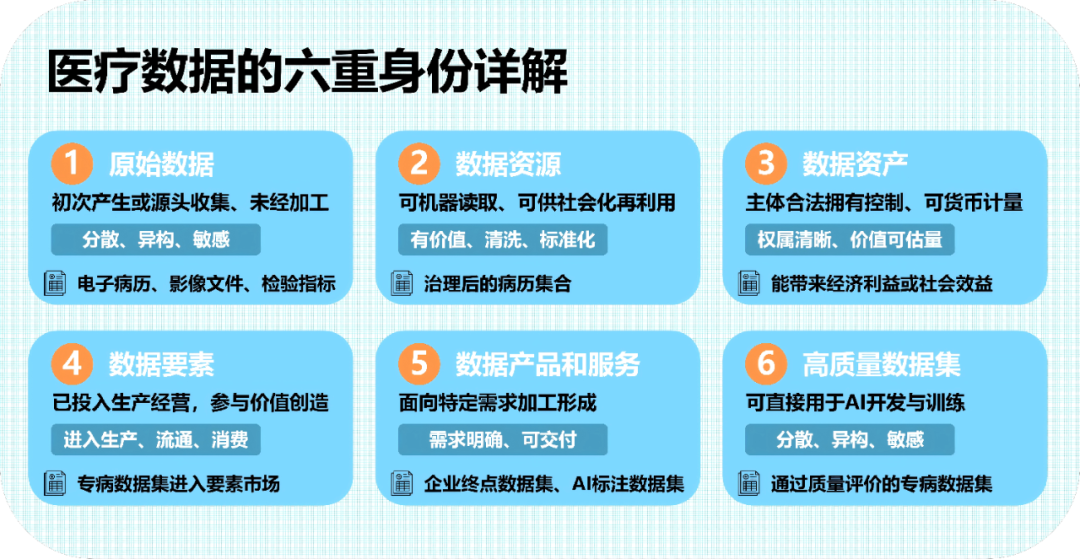
一、原始数据:医疗数据价值链起点的“原材料”
依据官方定义,原始数据是初次产生或源头收集的、未经加工处理的数据。
在医疗领域,原始数据的形态极为丰富:门诊与住院的电子病历、影像设备产出的医学影像文件、检验仪器回传的生化指标、病理报告、监护设备采集的生理信号……这些数据均真实记录还原了诊疗全过程,是整个医疗数据价值链的源头。
但原始医疗数据只是未经打磨处理的“原材料”,分散存储在HIS、LIS、PACS、EMR等不同系统中,格式异构杂乱,且涉及大量患者个人信息与疾病隐私,受法律法规严格约束,绝不能“拿来就用”。
因此,原始数据是医疗数据的“第一重身份”:真实原生,但未经加工,价值被封存,无法直接用于模型训练,也不能直接对外共享。
二、数据资源:治理完成后的第一个“正式身份”
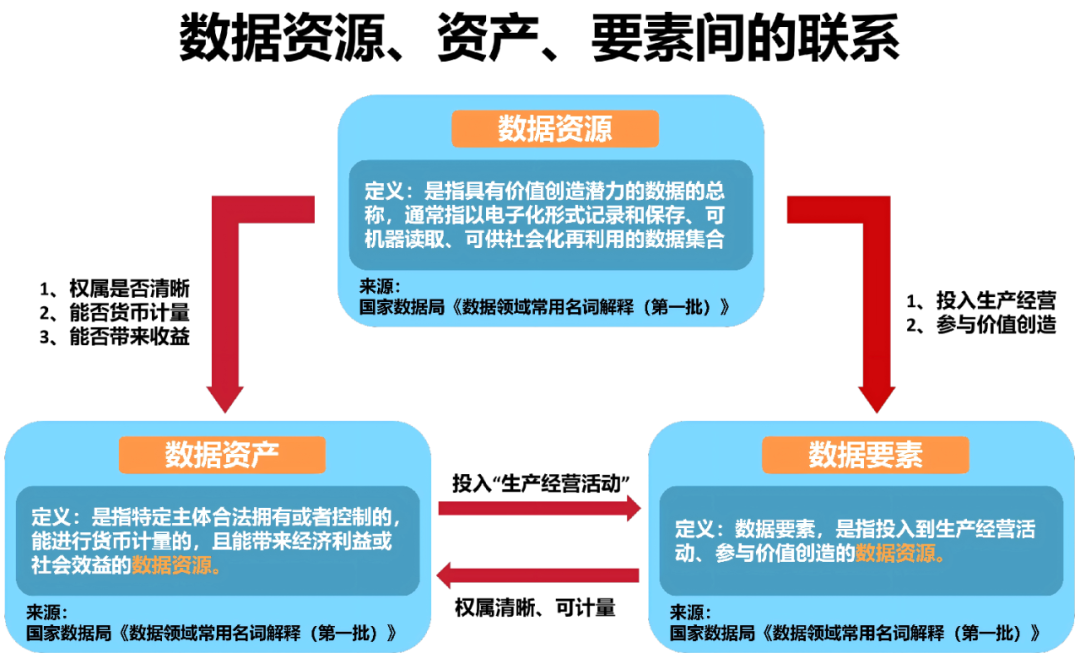
同样依据官方定义,数据资源是指具有价值创造潜力的数据的总称,通常指以电子化形式记录和保存、可机器读取、可供社会化再利用的数据集合。
从原始数据到数据资源,是数据第一次身份转化。散落在医院各类电子系统的碎片化原始数据资料需要经过规范化加工治理,才能真正成为数据资源,进入“可机器读取、可供社会化再利用”的状态。
经过脱敏、清洗、标准化,一份普通病历就从零散的原始记录,转变为可管理、可复用的数据资源。但此时它的权属未必清晰、价值未必可计量——它仅仅具有了”被使用”的潜力。这便是医疗数据的“第二重身份”。
三、数据资产:权属清晰、可计量的数据资源
在《数据领域常用名词解释(第一批)》中,数据资产是指特定主体合法拥有或控制的、能进行货币计量的,且能带来经济利益或社会效益的数据资源。
医疗数据要获得第三重“数据资产”的身份,必须同时满足三个条件:权属清晰、价值可货币计量、能产生经济利益或社会效益。数据资源只有完成权属界定、价值量化评估,判定确认能产出相关效益,才得以完成从“资源”到“资产”的身份跃迁。
相较于数据资源,数据资产实现了从“可用素材”到“可确权、可定价、可变现”的升级,成为权属明确、价值可量化、能够落地创造效益的数据形态。
四、数据要素:投入生产经营、参与价值创造的数据资源
《数据领域常用名词解释(第一批)》将数据要素定义为投入到生产经营活动、参与价值创造的数据资源。数据资源强调“具有价值创造潜力”,数据要素则强调“已经实际投入”。
“要素”一词自带宏观语境,强调数据进入生产、分配、流通、消费等经济环节。一份数据资源,只有真正投入生产经营活动、参与价值创造,才成为数据要素。例如,一份高质量专病数据集进入数据要素市场,被药企用于开展新药研发、被AI企业用于模型训练并参与收益分配,此时,它就不再是只具备潜力的数据资源,而是变成了真正参与产业价值创造的数据要素。
五、数据产品和服务:面向特定需求加工而成的数据交付成果
根据官方定义,数据产品和服务是指基于数据加工形成的、可满足特定需求的数据加工品和数据服务。
这一概念的核心判定标准在于是否匹配明确的业务需求。数据资源或数据资产本身不会自动成为数据产品,只有经过加工,能精准回应需求方明确需求的形态,才属于数据产品。例如,服务药企临床终点研究需求的专病数据集、供给AI企业用于模型训练需求的标注数据集。如果加工产出的数据成果没有明确对应的业务场景与需求,就难以称之为数据产品。
数据要素描述数据投入生产的运行状态,数据产品是面向需求加工后得到的实体交付形态,二者虽维度不同,但共同代表着医疗数据从单纯“持有”迈向“使用”。
六、高质量数据集:直接赋能AI模型开发训练的数据集合
依据《高质量数据集 建设指南(征求意见稿)》,高质量数据集是经过采集、加工等数据处理,可直接用于开发和训练人工智能模型、能有效提升模型性能的数据的集合。
这是医疗数据面向AI任务最具明确需求指向性的一重身份,核心目标就是直接支撑模型训练与效果验证。
在医疗产业落地建设过程中,有两个概念形态常常和高质量数据集相伴出现,即专病数据集与专病数据库。专病数据集是面向特定疾病,从临床数据中抽取、治理形成的数据集合,属于经过专业加工的阶段性成果;专病数据库则是承载和管理这些数据的底层基础设施,需不断补充新数据、迭代优化;而高质量数据集,则是经过规范化质量评价、被认证为可直接支撑模型训练的数据集合。三者相互关联,专病数据集是加工产出的数据成果,专病数据库是存储、管理数据的载体;经过规范化质量评价达到标准后的专病数据集,即为高质量数据集。
高质量数据集追求的不是脱离应用场景的绝对质量,而是数据与业务场景、任务目标、模型之间的适配程度:数据是否贴合具体的临床真实场景、是否匹配目标模型任务、训练效果能否通过验证。基于此,行业正在探索建立分级质量评价标准体系,通过规范化的质量评测与认证,让数据集的质量可衡量、可信任。
六种身份,依次对应数据的原生存续、标准化治理、资产确权、生产投入、市场交付、AI应用这一完整演进链路。厘清不同身份的内涵与边界,是有效破除数据定位模糊、合规边界难把握等行业痛点的关键。
对数据而言,身份界定直接关系其价值能否顺利释放。数据所处哪一重身份,就应当匹配相应的治理要求与合规路径。只有准确判断数据身份,治理、确权、流通、应用各环节才有据可依,医疗数据才能从沉淀在临床系统中的原始记录,稳步转化为可确权、可流通、赋能AI医疗创新应用的高价值资源,这也是医疗数据产业发展的核心命题。
作者简介
李曼,中国信通院云计算与数字化研究所生物科技部主任,工程师。主要从事医学人工智能、远程医疗器械、医疗器械安全、生命科技与大模型及未来产业等领域研究工作。参与支撑多个部委的课题、政策研究及相关国家/行业标准制定。
廖金华,信通院(江苏)科技创新研究院有限公司苏州高新区分公司工程师。主要参与智能化医疗器械网络安全研究与评价及数据集建设与评价研究工作。
联系方式:
电话:19963673162
邮箱:liaojinhua@caict.ac.cn
www.smartcity.team