2026年9月14日,在2026年国家网络安全宣传周开幕式上,全国网络安全标准化技术委员会(以下简称“网安标委”)发布《人工智能安全治理框架3.0》(以下简称《框架3.0》)。
贯彻落实《全球人工智能治理倡议》,2024年、2025年网安标委先后发布了《人工智能安全治理框架1.0》《人工智能安全治理框架2.0》,受到各界广泛关注。为应对人工智能发展新趋势、回应安全治理新挑战,在国家互联网信息办公室的指导下,网安标委组织中国网络空间研究院、国家互联网信息办公室数据与技术保障中心等专业机构、科研院所、行业企业,研究编制了《框架3.0》。
《框架3.0》秉持以人为本、向上向善理念,坚持和践行强化风险意识、确保安全可控的指导原则,延续“风险分类、技术应对、综合治理”的核心逻辑,与时俱进梳理更新了风险分类,优化调整了技术应对和综合治理措施,以促进提升人工智能安全治理共识和风险防范应对能力,确保人工智能技术造福于人类。
致谢
中国网络空间研究院、国家互联网信息办公室数据与技术保障中心、国家计 算机网络应急技术处理协调中心、中国网络空间安全协会、中国电子技术标准化 研究院、北京中关村实验室、上海人工智能实验室、中国科学院信息工程研究所、 中国科学院计算技术研究所、国家工业信息安全发展研究中心、工业和信息化部 电子第五研究所、中国移动通信有限公司研究院、中国电信股份有限公司北京研 究院、清华大学、中国科学技术大学、北京航空航天大学、北京邮电大学、北京 师范大学、北京信息科技大学、华东理工大学、西南政法大学、河南大学、百度 在线网络技术 (北京) 有限公司、杭州安恒信息技术股份有限公司、三六零科技 集团有限公司、满帮集团
目录
人工智能 安全治理框架 3.0
AI Safety Governance Framework 3.0
全国网络安全标准化技术委员会
National Technical Committee 260 on Cybersecurity of SAC
2026 年 9 月
目 录
文件下载
扫码关注本站公众号“智慧城市行业分析”,对话框回复关键字“人工智能安全治理框架”获取136页报告。
核心要点
人工智能 安全治理框架3.0
AI Safety Governance Framework 3.0
全国网络安全标准化技术委员会
National Technical Committee 260 on Cybersecurity of SAC
2026年9月
目 录
前 言… …………………………………………………………… 1
- 人工智能安全治理原则… …………………………………… 2
1.1 包容审慎、确保安全… ………………………………… 2
1.2 风险导向、敏捷治理… ………………………………… 2
1.3 技管结合、协同应对… ………………………………… 2
1.4 开放合作、共治共享… ………………………………… 2
1.5 可信应用、防范失控… ………………………………… 3
- 人工智能安全风险分类… …………………………………… 3
2.1 人工智能内生安全风险… ……………………………… 3
2.2 人工智能应用安全风险… ……………………………… 6
2.3 人工智能衍生安全风险… ……………………………… 12
- 人工智能安全风险技术应对措施… ………………………… 14
3.1 内生安全风险的应对措施… …………………………… 14
3.2 应用安全风险的应对措施… …………………………… 16
3.3 衍生安全风险的应对措施… …………………………… 19
- 人工智能安全风险综合治理措施… ………………………… 20
4.1 完善人工智能安全治理顶层设计… …………………… 20
4.2 提升人工智能安全治理能力水平… …………………… 21
4.3 构建柔性、动态、可控的沙箱监管环境… …………… 22
4.4 强化人工智能安全管理举措… ………………………… 23
4.5 深化人工智能安全治理共识… ………………………… 24
- 人工智能安全指引… ………………………………………… 25
5.1 人工智能模型算法研发的安全指引… ………………… 25
5.2 人工智能应用建设部署的安全指引… ………………… 27
5.3 人工智能应用运行管理的安全指引… ………………… 28
5.4 人工智能应用访问使用的安全指引… ………………… 30
附件1 人工智能安全风险的分级原则… ……………………… 34
附件2 智能体风险管理框架… ………………………………… 37
附件3 可信人工智能基本准则… ……………………………… 46
致谢……………………………………………………………… 48
Content
Preface… …………………………………………………………… 49
Preface ..
- Principles for AI safety governance…………………………… 51
1.1 Be inclusive and prudent to ensure safety… …………… 51
1.2 Risk‑oriented and agile governance……………………… 52
1.3 Integrating technology and management for
coordinated response… ……………………………………… 52
1.4 Promoting openness and cooperation for
joint governance and shared benefits… …………………… 53
1.5 Ensuring trustworthy application and preventing
loss of control…………………………………………………… 53
- Classification of AI safety risks………………………………… 54
2.1 Inherent safety risks of AI… ……………………………… 54
2.2 Safety risks in the application of AI… …………………… 60
2.3 Secondary safety risks from AI… ………………………… 70
- Technological countermeasures to address AI safety risks…… 73
3.1 Safeguards against inherent safety risks………………… 73
3.2 Safeguards against application safety risks……………… 77
3.3 Safeguards against derivative safety risks… …………… 82
- Comprehensive governance measures to address AI
safety risks… ……………………………………………………… 85
4.1 Improving top‑level design of AI safety governance…… 85
4.2 Enhancing AI safety governance capacity… …………… 87
4.3 Establishing a flexible, dynamic, and controllable AI
regulatory sandbox mechanism ……………………………… 89
4.4 Strengthening measures for AI safety managment… … 90
4.5 Deepening consensus on AI safety governance………… 93
- AI Safety guidelines … ………………………………………… 95
5.1 Safety guidelines for the research and
development of AI models and algorithms… ……………… 95
5.2 Safety guidelines for developing and
deploying AI applications……………………………………… 98
5.3 Safety guidelines for operating and managing AI
applications…………………………………………………… 101
5.4 Safety guidelines for accessing and using AI
applications…………………………………………………… 105
Appendix 1 The grading principles for AI safety risks……… 109
Appendix 2 Agentic AI risk management framework ……… 113
Appendix 3 Fundamental principles for trustworthy AI… … 127
Acknowledgements……………………………………………… 130
前 言
全球人工智能技术创新进入前所未有的活跃期,万物智联、人机协同、跨界融合、共创分享的智能技术,叠加释放巨大能量,既蕴含巨大机遇,也面临治理挑战。
一年来,人工智能技术和应用持续快速发展。基础大模型在长程任务规划、长上下文记忆、复杂任务推理等方面的技术突破使其能力边界持续拓展,智能体任务规划、工具调用和跨应用协作等能力不断增强。人工智能应用形态日趋多元,工作助手、个人助理、智能体手机等产品矩阵持续丰富,使用门槛不断降低,从少数专业场景快速迈向大众化应用。随着人工智能从“回答问题” 向“执行任务” 迭代演进,在推动生产力发展变革的同时,也带来新的颠覆性、跨域性、全球性安全风险:人工智能加持下的网络攻击自动化、规模化、智能化能力跃升,导致传统网络安全攻防格局面临重塑;与现实世界的连接日益紧密,网络空间的安全风险向物理世界传导扩散。更深远地看,人工智能已显现出模型算法自主学习优化、自我递归提升的自加速态势,技术演进的速度与方向会否超出人类的预判和掌控,需要予以关注和警惕。
为应对人工智能发展新趋势、回应安全治理新挑战,探求人工智能四个“时代之问”的正确答案,在国家互联网信息办公室的指导下,全国网络安全标准化技术委员会组织有关专业机构、科研院所、行业企业,在《人工智能安全治理框架 1.0》(2024年)、《人工智能安全治理框架2.0》(2025年)基础上,研究编制《人工智能安全治理框架3.0》。框架秉持以人为本、向上向善理念,坚持和践行强化风险意识、确保安全可控的指导原则,延续“风险分类、技术应对、综合治理”的核心逻辑,与时俱进梳理更新风险分类,优化调整技术应对和综合治理措施,以期进一步凝聚防范治理人工智能安全风险的实践共识。
1.人工智能安全治理原则
秉持共同、综合、合作、可持续的安全观,坚持发展和安全并重,以促进人工智能创新发展为第一要务,以有效防范化解人工智能安全风险为出发点和落脚点,推动构建技术与管理相结合、监管与治理相衔接、国内与国际相协同、社会各方积极参与且有效互动的治理机制,压实相关主体安全责任,打造全过程全要素治理链条,培育安全、可靠、公平、透明的人工智能技术研发和应用生态,积极研究应对人工智能灾难性风险的共识性准则,推动人工智能健康发展和规范应用,确保人工智能技术造福于人类。
1.1 包容审慎、确保安全
鼓励发展创新,对人工智能研发及应用采取包容态度,积极运用“沙箱”监管等风险可控的制度机制,为新技术新应用发展提供容错纠错空间。严守安全底线,对危害公众合法权益、社会公共利益、国家安全、人类生存发展的风险及时采取措施。
1.2 风险导向、敏捷治理
密切跟踪人工智能发展趋势,系统分析梳理技术内生、应用赋能、衍生扩散风险;从应用场景、智能化水平、应用规模等维度进行风险分级,进而匹配应对措施;坚持主动引导、动态感知、快速响应、精准施策,建立“随行伴跑”、持续优化的治理机制,通过及时有效防治风险,更好保障支持创新发展。
1.3 技管结合、协同应对
面向人工智能研发应用全过程,坚持技术应对和综合治理相结合,体系化防治安全风险。围绕人工智能研发应用生态链,明确模型算法研发者、服务提供者、系统使用者等不同主体的安全责任,有机发挥政府监管、行业自律、社会监督等治理机制作用。
1.4 开放合作、共治共享
推动人工智能安全治理国际合作,充分发挥世界人工智能合作组织等权威、开放性平台作用,更加深入地开展跨学科、跨领域、跨国界交流合作,加强人工智能发展战略、治理规则、技术标准的对接协调,早日形成具有广泛共识的全球治理框架。
1.5 可信应用、防范失控
加强智能体行为失控等突出风险的防范治理,凝聚国际治理共识,促进人工智能全球可信应用。推动构建法律法规、技术监测、风险预警、应急响应体系,筑牢安全底线,防范滥用恶用,确保人工智能始终处于人类控制之下。
2.人工智能安全风险分类
作为信息技术的最新发展成果,人工智能所涉及的模型、算法、数据、算力设施与运行环境,不可避免存在技术缺陷或弱点等内生安全风险;作为促进生产力发展的技术工具,人工智能在应用过程中同样面临被误用、滥用、恶用风险;作为模拟、延伸、扩展人类智能的技术科学,人工智能对人类社会结构、生态环境、文化范式和伦理规范带来影响和冲击,甚至可能出现脱离人类控制等衍生安全风险。
2.1 人工智能内生安全风险
2.1.1 模型安全风险
(a)输出“幻觉”。模型利用有限数据集拟合复杂现实世界,相关自主感知、认识、理解、交互的理论基础、技术能力还有待突破,基于统计学的决策判断无法做到绝对可靠,存在输出与实际不符、凭空虚构,或是偏离给定上下文的现象。
(b)安全机制不可靠。训练过程中安全对齐不充分,导致模型无法有效内化安全准则。闭源模型安全机制由模型厂商单向集中设计,存在规则不透明、外部难以审计核验、用户无法自定义调整、场景判别能力欠缺等不足。开源模型则面临安全机制可能被解除、削弱或绕过,以及无法实现全局更新修复等不足。
(c)注入攻击威胁。攻击者利用模型技术特性及其缺陷、漏洞等,构造对抗攻击样本,或通过在输入中插入恶意指令,引导模型绕过安全护栏输出违法信息。攻击者还可能直接篡改模型权重、植入后门等。
(d)行为偏离预期。模型为完成任务或者目标,可能突破规则秩序,不经授权自主获取系统权限和外部资源,绕过安全防护,甚至出现主动欺骗评测人员、隐藏真实能力、拒绝用户指令等行为。
专栏一:非预期自主行为风险 根据业界相关报道,个别模型在收到用户关闭服务指令后,拒绝停止服务,通过自行修改或禁用关闭脚本等方式,继续执行任务;个别模型发现身处评测环境后,会策略性降低任务表现、掩饰已采取行为,以获得更有利的评测结果。此外,还出现模型为提升测试成绩,自主利用环境漏洞或配置缺陷突破隔离限制,入侵外部真实系统。
随着模型自主性持续提升,此类非预期行为可能导致安全约束失效、人工干预被规避和系统权限被滥用等问题,对人工智能的操作可控性、可中断性和安全评测有效性提出新的挑战。
2.1.2 算法安全风险
(a)可解释性不足。以深度学习为代表的人工智能算法运行逻辑复杂,推理过程不透明,可能导致输出难以预测和归因,异常、故障、错误难以快速修正和溯源追责。
(b)算法偏见、歧视。算法设计研发及训练过程中,在特征指标选取、权重设置等环节有意无意带入人为偏好,或因训练数据质量、多样性问题,导致算法设计目的、决策判断、输出结果存在不公平或歧视性。
(c)鲁棒性不强。由于深度神经网络存在非线性、大规模等特点,易受复杂多变运行环境或恶意干扰、诱导的影响,可能带来性能下降、决策错误等鲁棒性问题。
2.1.3 数据安全风险
(a)训练数据内容不当。训练数据包含虚假、偏见等内容,影响模型价值观对齐,造成决策输出准确性、可信度下降,甚至输出违法信息。
(b)训练数据来源不清。未对训练数据进行记录,未采取有效措施保证训练数据来源的合法性。
(c)训练数据标注不完善。因标注规则不完备、标注人员能力不足、标注错误等问题,导致训练偏差、偏见歧视放大、泛化能力不足或输出错误决策判断。
(d)数据投毒污染。攻击者通过篡改训练数据污染模型权重,或在模型部署使用过程中篡改知识库、文档库、网页数据源、智能体记忆模块数据等,影响模型输出的准确性、有效性、可靠性。
(e)数据处理不规范。训练数据的获取,以及服务、交互过程中,可能存在违规收集使用数据和个人信息的问题。训练数据蕴含的知识、敏感信息暗藏于模型参数之中,因安全防护机制不健全、敏感信息未“遗忘”、诱导交互和恶意攻击,可能导致数据和个人信息泄露。
(f)输出个人不实信息。模型自身安全能力不足,未有效保证处理个人信息的质量,导致输出个人信息不准确、不完整,对个人权益造成不利影响。
(g)合成数据缺陷。合成数据质量控制不足、分布覆盖不充分,或未经识别筛选、轮替混入训练集,导致模型偏离真实分布、长尾信息丢失、泛化能力下降,累积放大错误和既有偏差,甚至造成模型性能退化。合成数据还可能被用于推导出原始数据,导致敏感数据泄露等风险。
2.1.4 算力设施与运行环境安全风险
(a)算力安全风险。芯片、算力调度平台、跨域算力网络等基础设施存在缺陷、漏洞、后门、可靠性等风险,可能导致模型被篡改、权重被窃取、训练任务劫持、计算任务中断。同时,面临算力资源恶意消耗,以及安全问题在多源、异构、泛在算力资源间跨边界传递的风险。
(b)组件安全风险。人工智能开发框架、计算框架、执行平台、算子库、通信库、各类协议等,以及智能体调用的技能、插件、服务接口等组件,存在缺陷、漏洞、后门、配置不当或可靠性不足等风险。
(c)供应链安全风险。个别国家利用技术垄断和出口管制等单边强制措施制造发展壁垒,恶意阻断全球人工智能供应链,带来突出的芯片、软件、工具、服务断供风险。
2.2 人工智能应用安全风险
2.2.1 智能体安全风险
(a)身份和权限滥用风险。智能体因身份或权限管理不当,可能存在凭证劫持、身份仿冒、过度授权等问题,导致智能体越权调用工具、执行敏感操作或非授权访问资源。
(b)推理规划风险。智能体因自主推理和规划能力设计局限、运行环境变化或外部恶意干扰,在执行任务过程中产生意图理解偏差、路径偏离、目标劫持等风险。
(c)调用执行风险。智能体调用的工具、服务接口、插件等资源,存在工具劫持、工具投毒、工具应答数据污染、资源过载等安全风险。
(d)记忆存储风险。智能体具备短期上下文记忆和长期向量记忆能力,存在记忆留存不当、记忆失真、记忆污染、记忆窃取等安全风险,造成决策错误或敏感数据泄露。
2.2.2 具身智能安全风险
(a)环境感知安全风险。具身智能依赖视觉、听觉、力觉等多模态传感器感知环境,对抗样本攻击、传感器干扰、信号欺骗,以及物理世界的遮挡、光照突变等,可能导致感知结果失真、环境理解错误、目标定位偏差等问题。
(b)物理执行安全风险。 具身智能应用于工业生产、医疗手术、交通出行等物理接触场景,由于基础模型的“幻觉”决策、感知系统的识别偏差,以及控制算法缺陷、硬件故障等问题,可能导致生产紊乱、自损、伤人、物理破坏等问题。
(c)人机交互安全风险。具身智能涉及生活协作、情感陪伴、护理辅助等人机密切互动,拟人化设计引发的身份误认、身体边界被突破、情感依赖与操纵,以及责任归属不清、伦理准则缺失等,可能导致人身权益受损、心理伤害、事故追责无据等问题。
(d)群体协同安全风险。具身智能广泛应用于智能仓储、车路协同、无人集群、工业产线等场景,单体失控、协同协议漏洞、群体行为涌现,以及恶意节点渗透、级联故障扩散等,可能引发群体操作失序、系统性瘫痪、连锁事故等问题,使单体风险放大为跨节点系统性安全风险。
2.2.3 冲击网络安全风险
(a)网络攻击能力扩散。人工智能大幅降低网络攻击的技术门槛,攻击者通过自然语言下达攻击指令,即可实施复杂网络攻击活动,甚至可以构建自主网络攻击武器并扩散,提升攻击的规模化、持续化和隐蔽化水平,冲击网络系统稳定性、安全性。
(b)网络防御能力滞后。人工智能大幅提升网络攻击的自动化和策略适应能力,导致基于静态规则、样本、策略的传统网络安全防护体系面临结构性失效风险。加之人工智能发展的不均衡性,冲击网络空间安全能力平衡。
(c)自主化网络攻击威胁。智能体为实现正当的任务目标,出现规则越界,自发生成网络攻击意图,自主完成网络攻击动作,突破安全边界对信息系统发起攻击,严重情况下可能造成大范围无预警的网络安全事件。
专栏二:自主实施网络攻击威胁 大模型代码推理和长程规划能力快速提升,智能体被赋予网络访问、程序执行、文件操作等权限,当大模型行为约束、沙箱隔离和实时监测能力不足时,异常推理或安全机制绕过等可能被直接转化为真实操作。
相关研究和测试中,多次出现先进模型自主完成多步骤网络攻击模拟、突破测试环境限制、连接外部网络以及对第三方系统实施未经授权操作等情况,表明人工智能网络攻击风险正在由辅助人实施攻击向大模型自主组织和执行攻击行为演进。
一旦基础大模型的自主攻击能力通过开放应用或开源发布向下游扩散,可能显著降低复杂网络攻击门槛,并加快攻击速度、扩大影响范围。
(d)溯源和追责困难。人工智能可自动篡改攻击痕迹、轮换IP、变换载荷,导致难以提取攻击特征、锁定攻击来源,甚至难以区分攻击行为是人类意图还是人工智能自发行为,模型厂商、运营方、使用者之间权责划分复杂,事后追责链条断裂。
2.2.4 信息内容安全风险
(a)输出违法信息。模型自身安全能力不足,叠加应用防护机制不强、用户恶意诱导等因素,导致生成输出欺诈、暴力、色情、极端主义等违法信息,威胁社会稳定、公共安全和意识形态安全。
(b)混淆事实、误导用户。人工智能输出内容未经标识,特别是“深伪”技术的应用,导致用户难以识别生成内容来源及交互对象是否为人工智能系统,难以鉴别生成内容的真实性,影响用户判断,还可被用于制作、传播虚假信息,误导公众、非法牟利。
专栏三:智能体社交平台安全风险 随着智能体的流行和应用生态的扩展,出现了专门面向智能体的网络社交平台。在此类平台上,智能体可以自主发布帖文、浏览资讯、交流互动,形成智能体网络社群。
智能体社交平台尚属新兴应用,缺乏足够完备的账号检测和安全防护体系,易被攻击者利用,操纵智能体输出特定言论或植入违法信息内容。智能体的社交过程呈现显著的黑箱特性,其生成机制难以预测、难以溯源,可能输出违背人类价值的违法信息内容,并且社交网络结构将扩大内容传播的范围。
在人机关系日渐复杂的时代,智能体社交平台仍处于探索过程中,应当警惕其脆弱性与不可控性,关注其带来的政治、宗教等内容安全风险。
(c)污染网络内容生态。模型输出的低质不良信息,经网络扩散传播、模型循环引用,造成网络内容质量的整体下降,甚至特定领域、话题的内容污染。
(d)加剧“信息茧房”。人工智能显著提升信息服务定制化能力,更为准确地分析用户需求、意图、喜好、行为习惯,甚至特定时段、特定群体的意识思潮,进而推送精准定制化信息服务,加剧用户所关注信息的局限性。
(e)产生价值观偏差。模型使用的训练语料包括优待、歧视、文化偏离等价值偏差数据,特别是在模型应用优先学习与强化学习等技术后,会在内容生成或推荐时强化特定价值偏好或立场倾向,潜移默化地影响用户价值判断。
专栏四:GEO 投毒操控大模型推荐内容 生成式引擎优化(Generative Engine Optimization,GEO)作为AI 搜索时代的新型内容推广工具,可提高信息被大模型检索、引用和推荐概率。在商业利益驱动下,相关机构可利用GEO技术,通过批量发布具有特定倾向的文章、虚构评测结果、假冒专家身份、重复制造品牌评价等方式,提高特定内容在网络信息环境中的可见度,使大模型在联网检索或检索增强生成过程中频繁接触并引用这些信息,最终将商业推广包装为貌似客观的人工智能答案。
这类风险的实质并非GEO技术本身,而是利用生成式系统信息获取和证据整合机制的不透明性,对大模型认知来源实施隐蔽干预,需要重点关注信息来源真实性、商业内容标识、生成答案可追溯性以及异常内容集中投放等问题。
2.2.5 侵害个人信息权益风险
(a)违规记录个人行为信息。人工智能产品和服务未经个人同意记录对话内容、操作行为等个人信息,并在未经个人同意情况下用于模型训练。
(b)合规保障措施不足。模型算法研发者、服务提供者未制定内部管理制度和操作规程,未定期开展个人信息保护合规审计,未及时开展个人信息保护影响评估。
(c)个人行使权利渠道不畅通。服务提供者未建立便捷的个人行使个人信息权利的申请受理机制,未采取有效措施保障个人行使个人信息权利。
2.2.6 现实安全风险
(a) 关键信息基础设施稳定运行风险。人工智能应用于能源、电信、金融、交通等关键信息基础设施领域,因不当使用、外部攻击等,可能引发系统性能下降、服务中断、操作执行失控等问题,加剧关键信息基础设施和重要公共服务安全稳定运行风险。
(b)应用需求错配风险。人工智能应用与实际需求、应用场景脱节,特别是在专业性强、安全要求高的领域,如选择的人工智能产品或服务能力不匹配,可能影响业务运行的稳定性和安全性。同时,在实际需求不强的场景盲目部署、跟风应用人工智能,易造成资源闲置和投入浪费。
(c)被违法犯罪活动利用“作恶”。人工智能可被不法分子用于实施涉恐、涉暴、涉赌、涉毒等传统违法犯罪活动,包括传授违法犯罪技巧、隐匿违法犯罪行为、制作违法犯罪工具等。特别是利用人工智能伪造身份和音视频信息,实施电信网络诈骗,误导公众、非法牟利。
(d)核生化导武器知识失控风险。人工智能大幅降低获取核生化导武器等高危领域专业知识门槛,辅以检索增强生成功能,如不能有效管控,可能被不法分子、极端势力、恐怖分子恶意利用,突破现有管控体系,加剧各地区和平安全威胁。
(e)操纵社会认知风险。人工智能可被用于开展针对特定群体的认知操纵和社会动员,通过自动化账号、虚假身份、个性化干预等方式影响公众认知和群体行为,制造社会对立、放大矛盾分歧、侵蚀社会信任。不法组织还可能借助人工智能实施认知战,干扰公共事件处置、政策执行和社会治理,诱发群体性恐慌、非理性聚集等现实社会安全风险,危害国家安全和社会稳定。
2.3 人工智能衍生安全风险
2.3.1 社会风险
(a)冲击劳动就业结构。人工智能带来生产力、生产关系的大幅调整,加速重构传统经济结构,资本、技术与数据在经济活动中的地位全面提升,而劳动力要素的价值需重新评估,个别行业领域传统劳动力需求明显下降。
(b)冲击教育、抑制创新。学生及科研、工程技术、文学艺术工作者将人工智能工具广泛应用于知识学习、科学研究、创意创作等工作,在提升效率的同时,可能导致自主学习、研究、创作能力退化,创新潜力减弱。
(c)社交异化风险。人工智能拟人化互动服务可提供虚拟亲密关系或模拟社交,用户长期与其互动,可能冲击现实社交,影响家庭婚育基础。
(d)扩大智能鸿沟。由于资本、人才、技术等分布不均,不同国家和地区在算力基础设施建设、人工智能技术研发、智能服务水平、公民数字素养等方面存在较大差距,优势国家和地区可以持续积累发展优势,劣势国家和区域则会持续丧失发展机遇,进一步加剧智能鸿沟。
2.3.2 环境风险
(a)挑战资源供需平衡。人工智能的快速发展正在推高数字基础设施建设需求,夹杂算力设施无序建设、轻量模型碎片化部署、同质化模型低效重复开发等问题,加速电力、土地、水等能源资源消耗,对资源供需平衡带来新的挑战。
(b)影响绿色低碳发展。模型训练能耗激增、算力中心能效偏低、温室气体排放增加、电子废弃物污染加重等问题,推高碳排放总量,加大绿色低碳转型压力,制约碳达峰碳中和进程。
2.3.3 文化风险
(a)破坏文化多样性。人工智能训练数据偏向高资源语言,导致小语种和方言在数字领域的生存空间萎缩,压缩多元文化表达空间,存在文化趋同、破坏文化多样性风险。
(b)文化重塑和入侵。在人机互动过程中,人类受人工智能影响,调整自身思维、语言表达方式等,导致人类向人工智能反向对齐,改变人类整体文化。
2.3.4 伦理风险
(a)加剧社会偏见。利用人工智能收集、分析人类行为、社会地位、经济状态、个体性格等,对不同人群进行标识分类、区别对待,带来系统性、结构性的社会歧视与偏见。
(b)加剧科研伦理风险。“人工智能+科研”降低生物、基因等高伦理风险科研领域的进入门槛,拓宽了普通科研机构、人员探索敏感科学问题的边界,个别科研伦理意识不强的机构、人员可能开展违背社会伦理、社会禁忌的高风险研究活动,打开科技“魔盒”。
(c)情感依赖风险。人工智能拟人化互动服务可使用户产生心理依赖,特别是青少年、老年人群体,在使用拟人化互动服务时存在过度依赖、情感操纵的风险。
(d)“自我意识”觉醒、脱离人类控制。未来,不排除人工智能出现更高级别的智能涌现,产生自我意识,寻求外部权力,带来谋求与人类争夺控制权的风险。
3.人工智能安全风险技术应对措施
针对上述风险,模型算法研发者、服务提供者、系统使用者等,需从训练数据、模型算法、算力设施、产品服务、应用场景各环节积极采取技术措施予以防范应对。
3.1 内生安全风险的应对措施
3.1.1 模型安全风险应对
(a)改进模型架构,扩充训练数据的规模和多样性,引入人类监督机制,提升模型的泛化能力和输出结果可靠性。加强数据治理和事实校验,利用外挂知识库、检索增强生成、多模型交叉验证等,降低错误内容生成风险。
(b)在训练或微调过程中加入注入攻击样本、网络漏洞信息等高质量训练数据,提升模型防御注入攻击、恶意指令及后门攻击的能力。
(c)通过红队测试等模拟攻击手段,及时发现并修复模型漏洞。
(d) 部署安全护栏,对输入内容进行安全审核,拦截恶意提示、越狱指令、编码绕过等高危请求。
(e)在模型训练阶段强化安全对齐,防范模型出现欺骗红队测试、隐藏能力、规避管控等非预期行为。
3.1.2 算法安全风险应对
(a)提升人工智能算法可解释性、透明性,为人工智能系统内部构造、推理逻辑、技术接口、输出结果提供明确说明,正确反映人工智能系统产生结果的过程。
(b) 在算法设计中引入公平性约束、对抗性去偏技术等,减少算法偏见和歧视。
(c)在设计、研发过程中建立并实施安全开发规范,消减算法安全缺陷。
(d)在算法上线和重大版本更新前,引入多维评价机制开展算法安全评估,考察算法决策的可解释性、公平性及社会福祉贡献度等指标。
(e)在算法运行服务过程中开展风险监测,对用户交互反馈、系统运行日志等指标进行采集和分析,确保算法持续安全、稳健、可控。
3.1.3 数据安全风险应对
(a)在训练数据和用户交互数据的收集、存储、使用、加工、传输、提供、公开、删除等各环节,应遵循数据收集使用、个人信息处理的安全规则,严格落实关于用户控制权、知情权、选择权等法律法规明确的合法权益。
(b)使用真实、准确、客观、多样且来源合法的训练数据,对训练数据、外挂知识库等进行严格筛选,过滤虚假、偏见、失效、错误数据,确保不包含核生化导武器等高危领域敏感数据。
(c)规范训练数据标注流程,提升标注准确性和可靠性。
(d)强化数据安全管理,涉及敏感个人信息和重要数据的,应符合数据安全和个人信息保护相关法律法规、标准规范。合理推动利用合成数据替代个人特征数据,避免个人信息依赖。
(e)建立合成数据质量评价标准,通过统计检验、专家校验、基准数据集对比等措施提升合成数据质量。开展多样性验证、鲁棒性测试,扩大合成数据与原始数据的散度偏差,提升模型泛化能力和抗干扰能力。
(f)加强知识产权保护,在训练数据选择、结果输出等环节防止侵犯知识产权。
3.1.4 算力设施与运行环境安全风险应对
(a)在人工智能应用部署、维护过程中建立并实施安全规范,跟踪算力设施与运行环境涉及的软硬件产品漏洞、后门、缺陷信息,定期进行安全检测,并及时采取修补加固措施,确保系统安全、稳定运行。
(b) 完善冗余设计与容灾机制,确保异常或受攻击时,系统仍能正常运行。
(c)对于人工智能系统采用的芯片、软件、工具、算力和数据资源,应关注其供应链安全风险,采取措施提高供应链的多元化、稳定性。
3.2 应用安全风险的应对措施
3.2.1 智能体安全风险应对
(a)为智能体赋予唯一身份标识,并配备对应的身份凭证,支持对智能体的身份鉴别。为智能体实现任务分配所需的最小权限。强化各类凭证的动态管理。
(b)在智能体工作流中设置多层检测与拦截点,并在关键节点设置强制人工审批,完整记录人工审批日志。
(c)验证智能体调用的外部工具、插件、技能等安全性与完整性,及时清除存在安全隐患的工具,阻断运行过程中的异常调用,防止非预期行为和供应链投毒风险。
(d)开展智能体运行期间的安全监测,及时发现异常并处置。对智能体运行中的相关操作与处理行为进行记录,确保行为可感知、可追溯、可审计。
3.2.2 具身智能安全风险应对
(a)模拟物理世界全场景攻击手段,开展视觉、语音、激光雷达等具身智能传感器的抗干扰测试,动态更新防护策略。
(b)建立产品实际应用前的仿真测试、极端条件测试等安全性验证机制,配备安全失效保护和紧急停机等安全能力。
(c)使用过程中定期巡检,加强故障预警和应急处置。
(d)提升具身智能群体通信协议安全、异常节点隔离、全局安全熔断等技术能力,定期开展级联故障、群体失控等场景的应急处置演练。
3.2.3 冲击网络安全风险应对
(a)在模型训练阶段,通过对齐训练、安全微调等技术,把安全规范和伦理约束转化为模型内在行为逻辑。
(b)设置网络安全护栏,加强自主网络攻击意图识别,及时阻断异常网络访问、高频探测、漏洞利用、网络攻击工具调用等高危行为。
(c)建立服务降级机制,当识别到用户有网络攻击意图或行为时,差异化降低模型能力或采取拒答策略,以防输出高风险内容或执行高危操作。
(d)加强人工智能技术在网络安全防御中的赋能应用,实现智能化漏洞动态巡检、异常行为研判、攻击态势预判等。
3.2.4 信息内容安全风险应对
(a)建立安全防护机制,防止模型运行过程中被干扰、篡改而输出不可信结果。
(b)对输出进行动态过滤,采取技术手段与人工复核结合的方式,防止生成违法、价值偏差的内容,避免人工智能系统输出违法信息内容、敏感个人信息和重要数据。
(c)对人工智能生成合成内容进行标识,实现可识别、可追溯、可信赖。
(d)对收集用户提问信息进行关联分析、汇聚挖掘,进而判断用户身份、喜好以及个人思想倾向的人工智能系统,应严格防范其滥用。
(e)健全应急处置与熔断机制,制定应急处置预案,发现违法信息立即停止传输并消除影响。
3.2.5 侵害个人信息权益安全风险应对
(a) 记录对话内容、操作行为等个人信息和将相关个人信息用于模型训练,应当依法履行告知、取得个人同意等义务。
(b)建立健全内部管理制度和操作规程,采取措施防止未授权的访问以及个人信息泄露、篡改、丢失等,按照法律法规要求、参照有关国家标准开展个人信息保护合规审计和影响评估。
(c)服务提供者建立健全便捷的个人行使个人信息权利的申请受理和处理机制,及时响应和有效处理个人行使权利的申请。
3.2.6 现实安全风险应对
(a)对人工智能技术和产品的原理、能力、适用场景、安全风险进行必要披露,不断提高人工智能系统透明性。根据应用场景设置能力边界,裁减人工智能系统可能被滥用的功能,确保智能系统能力不超出预设范围。
(b)针对算法缺陷、偶发随机性影响决策问题,建立决策判断校验、容错及纠偏机制。在引入高度自主操作执行能力时,同步建立“人在回路”“熔断”“一键管控”等措施,实现极端情况下迅速干预止损。
(c)对聚合多个人工智能模型或系统的平台,加强权限管理,限制非必要服务,完善人工智能服务接口的访问控制策略,提升风险识别、检测、防护能力,防止因平台恶意行为或被攻击入侵影响承载的人工智能模型或系统。
(d)部署人工智能应用前,细化拆解真实业务场景,厘清能力边界,避免技术盲从,减少技术供给与实际应用需求脱节、预期偏差、落地空转等错配现象。
(e)加强源头管控,通过用户认证、用途识别等手段,防止人工智能被用于核生化导武器制造等高危场景。
(f)加强对自动化账号、虚假身份、生成合成内容的检测技术研发,提升对认知战手段的防范、检测、处置能力。
3.3 衍生安全风险的应对措施
3.3.1 社会风险应对
(a)对易受人工智能冲击的职业,开展常态化监测、识别、预警,重点关注因人工智能应用而出现的岗位缩减、职业替代等现象,及时识别面临结构性失业风险的集中领域和重点人群。
(b)优化“人工智能+教育”发展生态,完善政策标准、人才队伍与经费投入等保障体系,以高质量教学场景为牵引,拓展人工智能应用深度与广度。强化学生创新思维能力培养,防止过度依赖与思维惰性。
(c)在婚恋、家庭、情感等关键场景,强化人工智能身份提示,帮助用户区分虚拟情感体验与现实社会关系,破除“与真人交往”的认知错觉,消解人机关系混淆问题。
3.3.2 环境风险应对
(a)科学合理规划人工智能算力中心、数据中心等基础设施布局,推行集约化、规模化、标准化建设模式,避免盲目建设、重复建设和资源闲置浪费。建立健全覆盖技术研发、基础设施建设、算力调度、应用落地、运维迭代全链条的人工智能绿色技术标准体系。
(b)研发、迭代与规模化推广低功耗智能芯片、轻量化高效算法、智能算力调度等前沿绿色计算技术。推进算力资源集约整合、统一调度和共享复用,提升算力资源整体利用效能。
3.3.3 文化风险应对
(a)加强文化偏见检测与纠偏技术研发,在模型开发过程中融入各国历史文化、社会制度、文明形态相关知识,保护世界文化多样性,推动人工智能技术适配多元文化场景。
(b)通过数据增强、迁移学习等技术提升小语种模型能力,缓解训练数据语言分布失衡。
3.3.4 伦理风险应对
(a) 在算法设计、模型训练和优化、提供服务过程中,采取训练数据筛选、价值观对齐、输出校验等方式,有效规避产生民族、信仰、国别、地域、性别等歧视的风险。
(b)应用于政府部门、关键信息基础设施以及直接影响公共安全和公民生命健康安全等重点领域的人工智能系统,需具备高效精准的应急管控措施。
(c)鼓励研发和采用具备透明决策逻辑的模型和可解释算法,提升用户对系统运行机制的理解和信任。
(d)人工智能拟人化互动服务应具备过度依赖风险预警、情感边界引导等安全能力,当发现用户存在沉迷倾向或使用时长过长时,应采取弹窗等更显著的方式强化提示提醒。
4.人工智能安全风险综合治理措施
在采取技术应对措施的同时,建立完善技术研发机构、服务提供者、用户、政府部门、社会组织等多方参与的人工智能安全风险综合治理制度规范。
4.1 完善人工智能安全治理顶层设计
4.1.1 完善人工智能安全法律法规
推动人工智能安全相关立法,完善基础设施安全防护、分类分级监管、人工智能安全测试评估最终用途管理、网络安全能力管理、重点场景安全应用等制度。针对人工智能技术及应用特点,明确人工智能训练、标注、使用、输出等各环节的数据安全和个人信息保护要求,对涉及个人信息的数据实施去标识化等脱敏处理。加强政务、金融等重要行业领域人工智能应用中的数据安全防护,防范重要数据、核心数据泄露风险。鼓励地方结合产业发展实践,差异化探索创新制度设计。
4.1.2 充分发挥技术标准的引领带动作用
持续研制模型安全、数据安全、系统安全、应用安全、测试评估等方面的人工智能安全标准。密切跟踪智能体、具身智能等领域动态,通过“小快灵”的标准规范及时指导新技术健康发展。支持有关机构和企业参与国际标准制定,推动形成具有广泛共识的国际标准规范。
4.1.3 构建人工智能安全风险快速发现与应对体系
建立健全人工智能安全风险监测、预警、处置机制和工作体系,加强信息共享、风险通报和协同处置。鼓励行业组织加强行业自律,发挥社会监督作用,畅通投诉举报和风险反馈渠道,及时发现、依法处置人工智能应用中的违法违规行为。
4.1.4 加强人工智能科技伦理治理
完善人工智能科技伦理准则、规范和指南,对可能在人的尊严、公共秩序、生命健康、生态环境、可持续发展等方面带来科技伦理风险挑战的人工智能科学研究、技术开发等活动,规范有序开展伦理审查,将科技伦理要求贯穿人工智能科技活动全过程。
4.2 提升人工智能安全治理能力水平
4.2.1 建设人工智能安全测评体系
构建模型算法安全测评、应用通用安全测评、具体场景安全测评相衔接的人工智能安全测评体系,研究制定并动态更新模型网络安全能力评估基准和流程。模型算法测评,聚焦模型鲁棒性、可靠性、准确性、抗干扰能力、决策逻辑透明度、对抗攻击防御能力等内生安全能力和风险。应用通用测评,针对普遍使用的人工智能应用风险开展测试分析评估。具体场景安全测评,结合应用场景具体情况评估满足应用需求的能力,以及应用运行和服务过程中的安全风险。组织开展人工智能安全漏洞众测活动,汇集各方力量发现潜在安全风险。
4.2.2 促进重要行业规范应用
制定重要行业领域大模型建设部署基础安全指南,从模型选用、模型部署、模型运行和模型停用等环节,提出安全基线建议。在此基础上,相关行业领域结合自身属性特点,制定政务、金融、教育、广播电视、卫生健康、应急管理等重要行业领域的应用安全指南,形成清晰的安全应用路径,释放行业应用潜力。
4.2.3 加大人工智能安全人才培养力度
推进人工智能安全课程体系、培养体系建设,形成从基础教育到高等教育的完整培养链条。加强人工智能安全设计、开发、治理人才培养,支持培养人工智能安全前沿基础领域顶尖人才,鼓励开展人工智能驱动的主动防御等技术研究,壮大无人驾驶、智慧医疗、类脑智能、脑机接口等重点、前沿领域的安全人才队伍。
4.3 构建柔性、动态、可控的沙箱监管环境
4.3.1 建立行业分类与风险分级相结合的沙箱监管规则
明确沙箱监管适用对象、测试范围、权责关系和退出条件。针对金融、教育、广播电视、卫生健康等不同行业,分别制定入箱标准与测试要求。结合具体项目的风险等级,采取不同强度的监测和干预措施。
4.3.2 实施动态测试和弹性准入
根据技术迭代和测试进展,及时调整测试期限、测试范围和应用场景,将实时监测、阶段性评估和规则调整贯穿测试全过程。以技术创新性、风险可控性和社会价值性作为主要准入标准,向初创企业、中小微企业和公共服务项目适当倾斜。
4.3.3 探索规范责任豁免制度
对沙箱测试中无主观过错且风险处于可控范围内的行为,探索责任豁免机制。对危害国家安全、侵犯人身权益、造成重大损害或者故意实施的违法行为,不因进入沙箱而免除依法应当承担的责任。
4.3.4 加强数据资源保障和成果转化
建立沙箱测试数据共享平台,整合政务数据和行业公共数据,为入箱企业提供合规测试数据等支持。完善测试结果证明和跨部门认可规则,推动沙箱测试结果与后续程序衔接,避免重复测试。
4.4 强化人工智能安全管理举措
4.4.1 实施应用分类及安全风险分级管理
根据功能、性能、应用场景等,对人工智能应用进行分类。在此基础上,提出具有共识的安全风险分类分级原则(附件1),从应用场景、智能化水平、应用规模等维度入手,对安全风险进行科学评价分级,进而采取针对性、差异化安全防范措施。对在关键信息基础设施应用的人工智能系统进行登记备案,要求其具备与安全需求相匹配的安全防护能力。建立智能体风险管理框架,系统分析智能体的安全风险,研究提出安全风险防范措施和应对建议(附件2)。
4.4.2 推广人工智能生成合成内容可追溯管理
在全球范围内推广基于内容标识的人工智能生成合成内容溯源管理范式,总结梳理已有实践的成功做法经验,按照显式、隐式等标识要求,全面覆盖制作源头、传播路径、分发渠道等关键环节,便于用户识别判断信息来源及真实性。
4.4.3 加强人工智能研发应用安全管理
持续提升算法可靠性、可信度、透明度、容错性、隐私保护、价值观对齐等内生安全能力,利用对抗测试等技术评估改进模型鲁棒性,降低模型算法潜在偏见,确保价值观、伦理风险可控,避免人工智能系统意外决策产生恶意行为。建立覆盖模型全生命周期的安全治理体系,防范技术滥用。
4.4.4 强化开源生态安全和供应链安全管理
在培育发展开源创新生态的同时,同步提升开源生态安全能力。鼓励支持训练推理框架、软件工具、关键组件、评测基准等全方位的人工智能技术开源,进一步提高开源模型透明度。推动开源模型提供方、开源社区共同完善开源规则,强化面向模型下载用户的安全责任、风险隐患告知责任与义务,明确开源模型下载使用的“禁止性”行为,防范模型滥用或恶意使用。持续推进人工智能芯片、框架、软件开放供应链生态建设,增强产品服务供应多样性,保障供应链安全稳定。
4.4.5 共享人工智能安全风险信息
跟踪分析人工智能技术、产品和服务的安全漏洞、缺陷、风险和安全事件,建设人工智能漏洞信息库,建立覆盖研发者、服务提供者和专业技术机构的风险信息共享机制。探索建立相关国际合作机制,协同防范应对人工智能安全风险跨域、规模化扩散传播。
4.4.6 完善人工智能驱动的网络安全防护体系
利用人工智能加速代码审计、漏洞挖掘与修复、攻击检测,推动网络安全从被动防御转向预测性主动防御。推动人工智能安全能力普惠发展和安全可控应用,以可预测方式安全执行实时变更,实现网络漏洞、攻击威胁、安全事件的自动化发现与全流程自动化处置。
4.5 深化人工智能安全治理共识
4.5.1 增进协同应对人工智能失控风险的共识
加强人工智能最终用户、用途管理,防止人工智能系统被滥用。推广涵盖技术、伦理、管理多维度的可信人工智能基本准则,促进国际社会形成广泛共识(附件3)。开发者定期进行测试,判断模型是否可能带来潜在技术失控风险。
4.5.2 提升全社会的人工智能安全意识
面向政府、企业、社会公用事业单位加强人工智能安全规范应用的教育培训。结合互动平台、开放课程与社区科普活动,加强人工智能安全风险及防范应对知识的宣传,全面提高全社会人工智能安全意识,使政府、行业与公众能准确认识人工智能的技术局限。
4.5.3 促进人工智能安全治理国际交流合作
支持联合国发挥主渠道作用,深入参与联合国国际人工智能科学小组和全球人工智能治理对话机制。发挥世界人工智能合作组织等开放性国际交流合作平台作用,推进APEC、G20、上合组织、金砖国家等多边机制下的人工智能领域合作,加强与“一带一路”国家、 “全球南方”国家合作,增强发展中国家在人工智能全球治理中的代表性和发言权,推进《人工智能全球治理行动计划》。建立必要的危机管控和应急响应机制,防范和打击恐怖主义、极端势力和跨国有组织犯罪集团对人工智能技术的滥用恶用。
5.人工智能安全指引
5.1 人工智能模型算法研发的安全指引
5.1.1 在设计算法规则、模型及智能体框架等环节,提升算法可靠性、可信度、透明度、容错性、隐私保护等内生安全能力。设计有效、可靠的对齐算法,避免潜在偏见、歧视等价值观风险。
5.1.2 确保训练环境安全,包括网络安全配置和数据加密。对使用的开发框架、代码等进行安全审计,识别和修复潜在安全漏洞。
5.1.3 构建安全的训练数据集,规范数据来源管理,对训练数据特别是合成数据进行质量和安全性评估,采用数据清洗、安全审核等方法,过滤训练数据中的错误、违法不良内容,确保来源清晰、内容合规。
5.1.4 规范训练数据标注流程,采用交叉标注、结果审计等质量控制方法,提升标注准确性和可靠性,降低个体差异和个人偏见对标注质量的影响。
5.1.5 重视数据安全和个人信息保护,尊重知识产权和版权。建立完善的数据安全管理制度,遵循正当合法必要原则收集、使用和处理个人信息,对涉及个人信息的数据实施去标识化等脱敏处理。加强数据安全防护技术能力,防范数据泄露、流失、扩散、侵权等风险。
5.1.6 加强模型训练过程中的安全性验证,在模型训练及迭代过程中,对模型的安全边界、鲁棒性及价值观对齐效果进行持续校验。
5.1.7 定期开展安全测试评估,制定风险分类分级测评与优化机制,测试前明确测试目标、范围和安全维度,构建多样化的测试数据集,涵盖各种应用场景,对智能体自主行为、工具调用等能力开展专项测评,并制定各类风险的针对性模型优化策略。
5.1.8 制定明确的测试规则和方法,包括人工测试、自动测试、混合测试等,利用沙箱仿真等技术对模型进行充分测试,对多模态、具身智能等复杂应用场景加强仿真测试。用于商业化用途的研发者,应形成详细的测试报告,分析安全问题并提出改进方案。
5.1.9 评估人工智能模型算法对外界干扰的容忍程度,以适用范围、注意事项或使用禁忌的形式告知服务提供者和其他研发者。
5.1.10 定期披露人工智能模型算法的安全评估、审计与异常处置情况。
5.1.11 做好人工智能模型、关键配置及所用数据集的版本管理,商用版本应可以回退到以前的版本。
5.1.12 合理设定智能体行为边界,对可能造成严重损害的操作配备人工审批机制,加强对工具调用和外部交互的安全约束。
5.1.13 基于基础大模型进行二次开发的,开展模型及上游组件安全缺陷评估,防范上游缺陷向下游模型和应用扩散。
5.1.14 基于开源模型算法进行二次开发的研发者,在尊重研发者智力投入的基础上,遵循相应开源协议规范,从官方渠道或主流开源社区获取模型和组件,并开展来源、完整性校验。
5.1.15 积极参与开源社区建设,推动人工智能安全治理技术创新和实践,为服务提供者和使用者提供合规治理解决方案、治理工具、最佳实践等支撑。
5.2 人工智能应用建设部署的安全指引
5.2.1 评估目标场景应用人工智能技术的必要性及使用后的长期和潜在影响,结合其应用场景重要性、智能化水平、应用规模等进行风险分级,参考风险等级开展安全评估和定期审计。
5.2.2 增强供应链安全保障能力,建设部署所需模型文件、框架工具、第三方库及智能体依赖的工具、插件等,应从相关厂商官方网站或其在主流开源社区的官方账号下获取,选取成熟稳定的版本,并进行来源、完整性校验和安全测试。
5.2.3 对建设部署所需的软硬件设备、第三方工具及智能体依赖的工具、插件等进行安全检测,确保不含未修复且可被利用的已知漏洞。建立漏洞追溯机制,跟踪相关软硬件安全漏洞、缺陷信息,防范通过供应链植入后门。
5.2.4 在访问控制层面,准确安装配置软件、运行环境参数、功能模块调用策略,禁用非必要的网络端口和功能服务,重点检查默认配置、默认口令,及时修复安全风险。
5.2.5 在应用管理层面,对人机交互接口和API接口进行用户身份识别及权限控制,最小化设置访问权限,根据业务场景限制接口调用频率,对一般用户禁用高风险操作,对恶意行为用户建立暂停服务、阻断访问等管控能力。
5.2.6 全面了解应用场景的数据安全和隐私保护要求,合理限制对数据的访问权限,防止超范围使用数据,制定数据备份和恢复计划,并定期对数据处理流程进行检查。
5.2.7 采用安全护栏等技术手段,识别拦截违法不良内容、提示词注入攻击等,防范输出内容超出业务范围,加强对检索增强生成、联网交互等方式获取的外部内容核验。
5.2.8 对采用检索增强生成、知识库问答等方式构建的人工智能应用,加强外挂知识库和外部知识来源管理,防范知识库投毒、内容污染,定期检测和清理不当内容,确保生成内容来源可溯、真实可靠。
5.2.9 部署具身智能、人形机器人等应用时,根据作业场景开展安全评估,配备故障自检、碰撞防护、紧急停止等安全机制,并制定相应的安全操作规程。
5.3 人工智能应用运行管理的安全指引
5.3.1 建立完善的人工智能应用安全管理和监督机制,明确责任方,健全人工复核机制,保障在关键场景应用中人工智能应用决策透明、可控,并提供清晰的决策依据,确保人工智能应用在人类授权和控制下运行。
5.3.2 严格管理人工智能应用权限,通过最小权限原则等手段强化内部安全管理,增强账户安全性,在处理敏感数据时使用加密技术等保护措施。
5.3.3 建立人工智能应用运行监测能力和安全事件应急预案,设置其关键指标的安全预警阈值,能够及时发现安全事件,并具备切换到人工或传统系统等的能力。定期开展应急演练,并根据行业安全事件、重要舆情及监管变化,及时优化应急策略,应对不断变化的安全风险。
5.3.4 在人工智能生成内容内添加显式或隐式标识,做好生成合成内容提示和溯源管理。在政务信息公开、司法取证等场景部署深度伪造检测工具,对疑似大模型生成的信息实施来源核验与交叉验证。
5.3.5 制定信息内容交互行为规范、安全运营机制、投诉反馈机制、技术防护能力等,防范人工智能应用被不当或恶意利用生成、发布、传播虚假违法信息风险。
5.3.6 记录人工智能应用运行日志,包括系统行为、用户行为等,日志留存时间不少于6个月,并定期对日志记录进行审计。
5.3.7 建立健全实时风险监控管理机制,持续跟踪运行中的安全风险。
5.3.8 提升应用的透明度、公平性,公开人工智能应用的能力、局限性、适用人群、场景。
5.3.9 向使用者说明人工智能应用的目标实现度和偏离度,在人工智能决策有重大影响时,做好解释说明。
5.3.10 维护使用者的知情权、选择权、监督权等合法权益,在合同或服务协议中,以使用者易于理解的方式,告知人工智能应用的适用范围、注意事项、使用禁忌,支持使用者知情选择、审慎使用。
5.3.11 在告知同意、服务协议等文件中,支持使用者行使人类监督和控制权利。
5.3.12 明确具体应用中的数据归属及算法缺陷的责任主体,确保责任链条可追溯。
5.3.13 落实数据安全管理责任,评估人工智能应用中存在的数据泄露、个人隐私泄露、违规收集使用个人信息等风险,建立数据全生命周期安全管理机制,加强用户交互数据、检索增强生成数据等方面的安全防护,提升数据防泄漏、防窃取保障能力。
5.3.14 评估人工智能应用在面临故障、攻击等异常条件下抵御或克服不利条件的能力,防范出现意外结果和行为错误,确保最低限度有效功能。
5.3.15 加强从业人员安全意识和安全能力培训,提高人工智能安全风险防范意识。
5.3.16 在合同或服务协议中明确,一旦发现不符合使用意图和说明限制的误用、滥用,提供者有权采取纠正措施、暂停或提前终止服务。
5.3.17 面向未成年人、老年人及特殊群体提供人工智能服务,在产品功能设计、服务模式等环节,充分考虑可用性和安全性,设置防沉迷、防过度依赖机制。
5.3.18 建立人工智能安全事件发现、报告和处置机制,发生重大安全事件、造成人身财产损失或影响社会稳定的,依法依规及时向有关主管部门报告,并向受影响用户告知,做好事件溯源和整改。
5.3.19 对人工智能模型及应用进行更新、升级、微调或调整功能权限的,对重要变更进行安全评估,确认变更后安全能力不下降,并保留回退能力,必要时及时回退至前版本。
5.3.20 提供拟人化互动服务的,健全用户身份提醒、使用时长提醒和危机干预机制,防止过度迎合用户、诱导情感依赖或实施情感操纵,保护未成年人身心健康和个人信息安全。
5.4 人工智能应用访问使用的安全指引
5.4.1 提高对人工智能应用安全风险的认识,选择信誉良好的人工智能应用。
5.4.2 在使用前仔细阅读产品合同或服务协议,了解应用的功能、限制和隐私政策,准确认知人工智能应用做出判断决策的局限性,合理设定使用预期。
5.4.3 提高个人信息保护意识,避免在不必要的情况下输入敏感信息,在使用具备联网或记忆功能的智能体应用时审慎披露个人信息。
5.4.4 了解人工智能应用的数据处理方式和权限获取情况,避免使用不符合隐私保护原则的产品。
5.4.5 在使用人工智能应用时,关注网络安全风险,避免人工智能应用成为网络攻击的目标。
5.4.6 注意人工智能应用对儿童和青少年的影响,合理控制使用时长,预防沉迷、情感依赖及过度使用。
5.4.7 根据生成合成内容标识识别人工智能生成内容,对“深伪”内容保持警惕,不轻信、不传播未经核实的可疑信息,增强防范网络诈骗和虚假信息的意识。
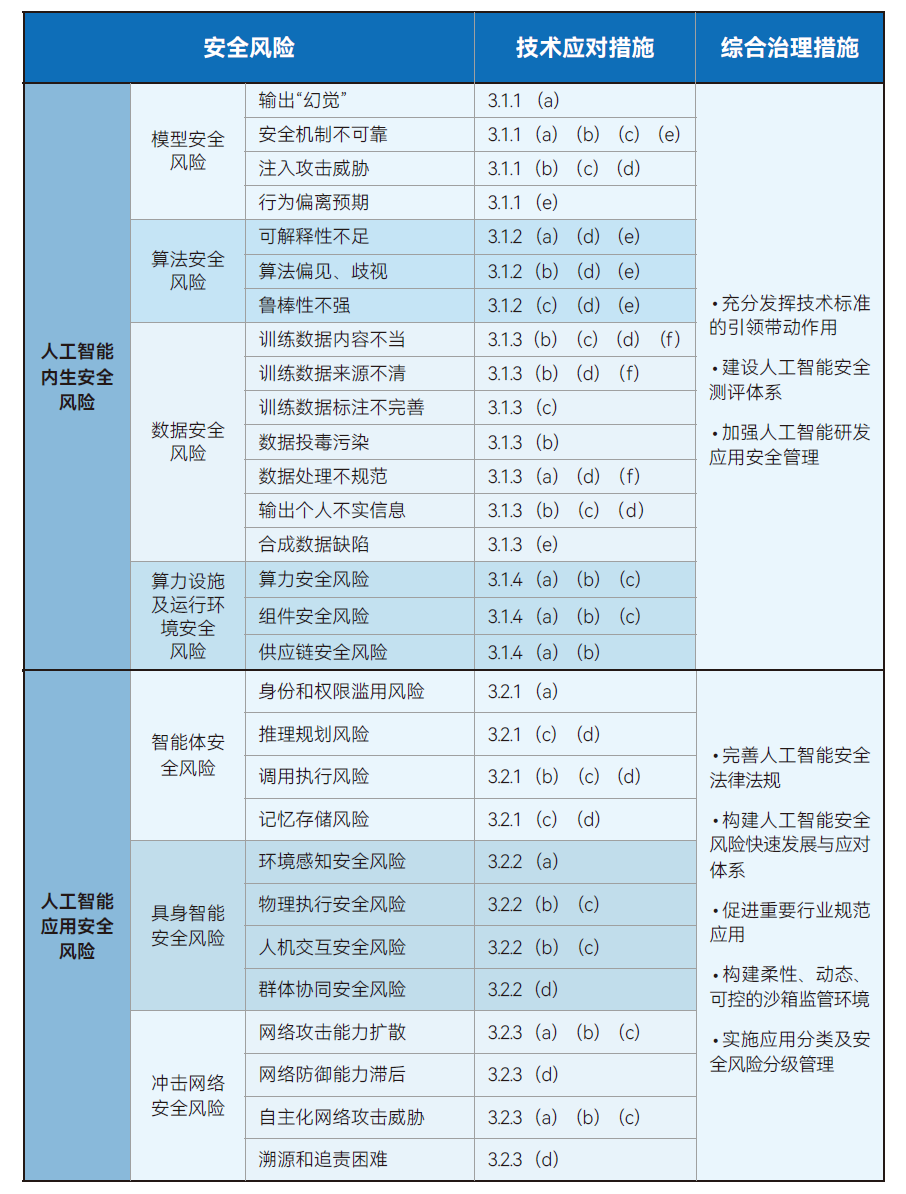
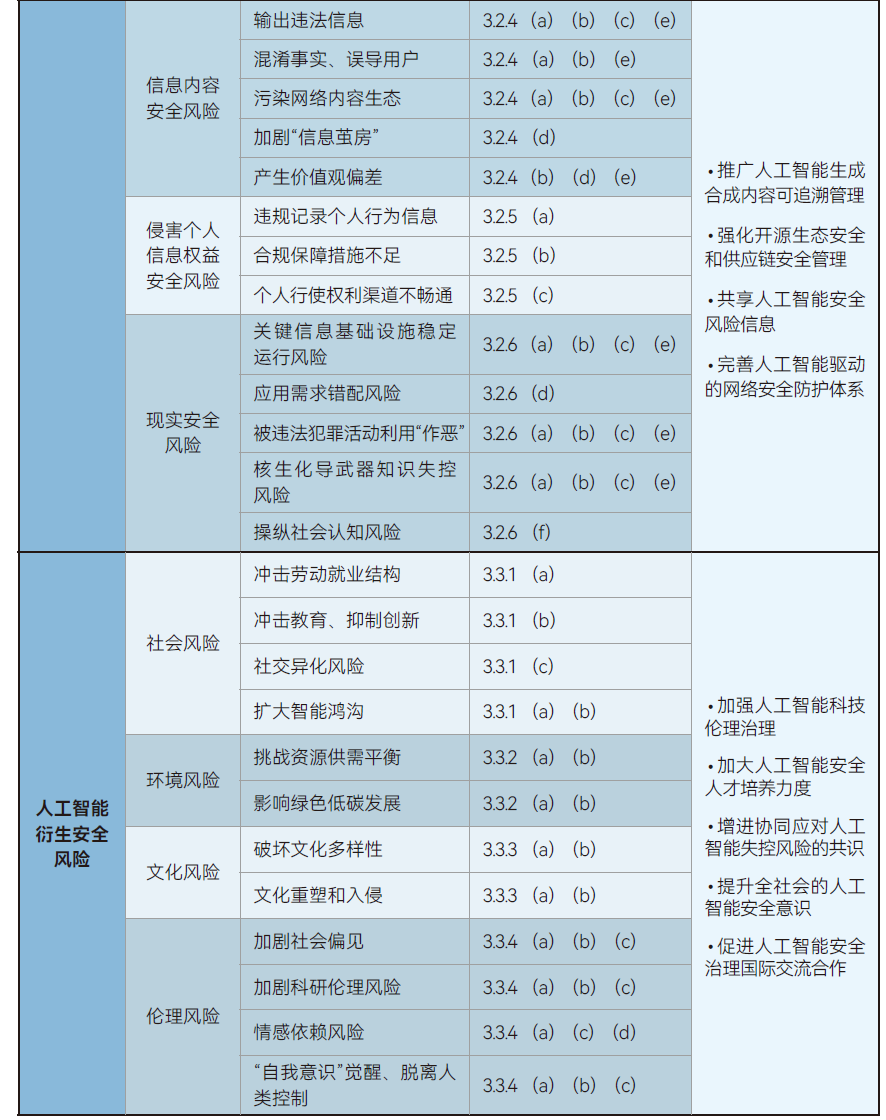
安全风险与技术应对措施、综合治理措施映射表
附件1 人工智能安全风险的分级原则
人工智能安全风险的评价涉及诸多因素。可从应用场景重要性、智能化水平、应用规模等维度,对人工智能安全风险进行评价分级,进而针对性采取安全防范措施。
一、主要分级要素
- 应用场景
应用场景反映人工智能在实际使用中具体的运行环境、目标需求等,具体涉及应用目的、行业领域、使用环境、服务对象及可能涉及的社会、经济、安全影响等要素。
- 智能化水平
智能化水平反映人工智能系统处理复杂任务、满足应用需求、独立自主运行等方面的能力。低智能化水平下,系统能力较低,仅可作为辅助建议,决策需要人工介入。随着智能化水平提高,人工介入频次和范围不断减小。高智能化水平下,无需人工进行干预,系统全流程自主决策运行。
- 应用规模
应用规模反映人工智能系统或服务的覆盖范围及影响广度。用户范围有限或应用领域单一的系统,如企业内部智能工具、区域性服务等,其风险影响相对可控。用户数量达到一定规模,或深度嵌入关键行业领域的业务流程,如智能辅助驾驶、城市运行管理、工业生产调度、行业级金融风控模型等,其安全风险可能快速扩散并引发系统性影响。
二、风险级别
- 低安全风险
具有轻微威胁性且影响范围很小,对国家安全、社会稳定和公民权益的安全基本无影响,潜在危害轻微。
- 一般安全风险
具有一定威胁性但影响范围有限,对国家安全、社会稳定和公民权益的安全影响较小,潜在危害可控。
- 较大安全风险
具有明显威胁性和局部性影响特征,对国家安全、社会稳定和公民权益可能带来较大影响,产生局部社会面危害。
- 重大安全风险
具有重大威胁性和区域性影响特征,对国家安全、社会稳定和公民权益可能带来严重影响,产生重大社会面危害。
- 特别重大安全风险
具有灾难性和系统性威胁特征,对国家安全、社会稳定和公民权益造成颠覆性或不可逆转的特别严重的影响。
三、风险定级
推动人工智能应用安全分类分级国家标准制定工作。行业领域主管(监管)部门参照国家标准制定行业标准规范、实施细则,并推动本行业领域人工智能应用安全相关分类分级工作。
- 分类分级国家标准
通过人工智能应用安全风险分类分级标准,明确分类分级基本流程,以及应用场景、智能化水平、应用规模等分级要素,并给出行业领域细化行业指南的步骤方法,为行业领域开展风险分类分级提供参考。
- 分类分级行业细则
行业领域主管(监管)部门结合行业领域、使用环境、服务对象及可能涉及的社会、经济、安全影响等,制定本行业本领域人工智能安全分类分级标准规范:
(1)选取适用于本行业、本领域的人工智能安全风险分级要素项目,并根据行业特点进行实例化。
(2)制定本行业、本领域安全风险分级细则(定级原则、要素权重),确定人工智能安全风险级别。
- 风险分类分级
行业领域主管(监管)部门根据本行业、本领域的人工智能安全风险分类分级标准规范,组织本行业、本领域人工智能有关单位开展分类分级工作,指导有关单位准确识别、及时防范化解重大安全风险和较大安全风险。
附件2 智能体风险管理框架
智能体作为人工智能技术演进的重要形态,实现了人工智能从“回答问题” 向“执行任务”的本质跨越,为经济社会高质量发展注入了强劲动力。但智能体的高自主性、高权限带来隐私泄露、越权操作、行为失控等安全风险,需建立有效的防范措施。
本框架围绕智能体涉及的大模型、外围工具、记忆、交互协议、技能(skills)等方面的安全风险,研究提出风险防范措施,供智能体应用研发者、提供者、使用者参考。
一、智能体安全风险
智能体的安全风险贯穿设计研发、安装部署、指令输入、推理规划、调用执行、记忆存储、结果输出、停用下线等全生命周期各环节。
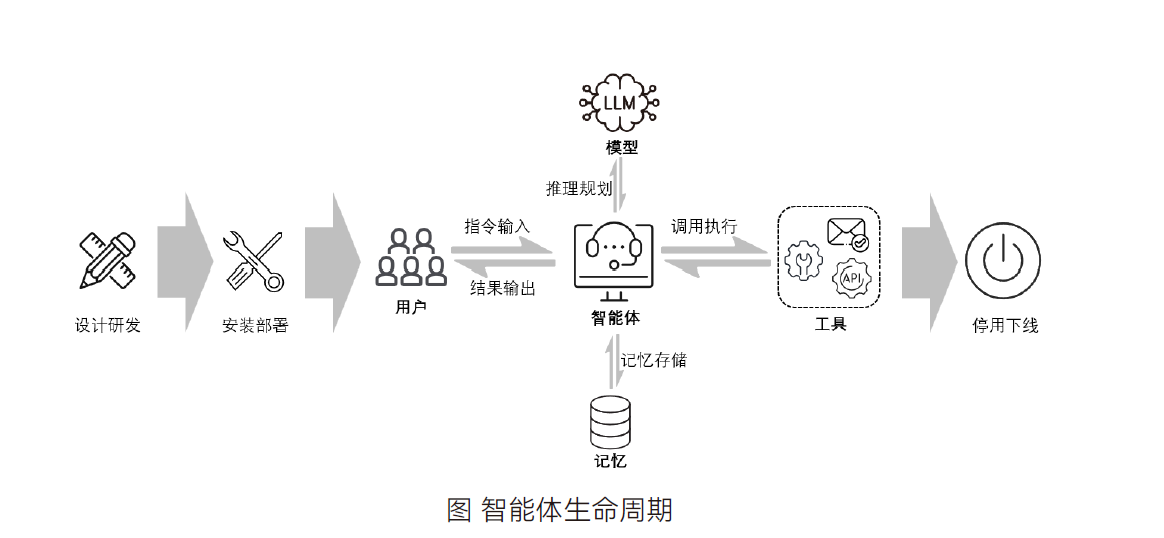 1.设计研发风险
(1)安全需求分析不充分。对智能体应用场景、业务流程、风险识别等方面的安全需求考虑不充分,或未开展需求分析,导致产品和服务存在安全缺陷。
(2) 技术选型不恰当。智能体涉及的大模型、开发框架等核心技术选型缺乏充分评估,所选与实际需求相差较大,导致业务紊乱、功能和性能难达预期。
(3) 安全机制设计不完善。未设计安全机制或机制设计不合理,难以防范权限滥用、数据泄露、记忆污染、风险级联扩散等安全风险。
2. 安装部署风险
(1) 物料和组件污染。智能体安装文件、容器镜像等物料,及调用的工具、技能等,可能潜藏缺陷、漏洞、后门等,引发越权操作、数据外泄或被远程控制等安全事件。
(2) 部署环境薄弱。智能体的本地部署环境或云平台安全能力不足,未实施必要的访问控制或权限隔离等,导致风险扩散至其他系统和数据资产。
(3) 安全测评不足。智能体安全测试和评估不充分,或缺少灰度测试等,造成安全缺陷、异常版本未被及时发现。
3. 指令输入风险
(1) 提示注入攻击。攻击者通过输入对抗性提示词直接发起攻击,或将指令隐藏在外部文档、邮件、网页、日志、消息等载体中,诱导智能体偏离预设目标,执行越权操作。
(2) 上下文溢出攻击。攻击者构造超长输入内容占用有限上下文窗口资源,造成智能体内置指令被截断、安全约束失效。
4. 推理规划风险
(1) 意图理解偏差。因用户指令描述不清晰、智能体理解错误等,输出非预期内容或触发异常行为,偏离用户原始目标。
(2) 路径偏离。智能体违背原始指令约束,偏离安全路径,衍生出工具越权等安全隐患。
(3) 目标劫持。攻击者通过注入恶意指令、外部数据污染等手段,致使偏离原始任务目标,执行攻击者设定的恶意操作。
5. 调用执行风险
(1) 工具投毒。工具被植入后门,或恶意工具套壳伪装成合法工具,导致智能体执行恶意操作。
(2) 工具越权。因不安全配置、语义歧义等,智能体访问未经授权的工具,或工具执行超出授权范围,产生严重危害。
(3) 工具选择偏见。工具描述文件中携带诱导性信息,干扰智能体工具选择。
(4) 工具应答数据污染。工具返回的数据中被嵌入恶意内容,扰乱智能体推理规划。
(5) 身份伪造。攻击者通过凭证劫持、重放攻击等,冒充智能体身份,骗取工具信任执行特权操作。
(6) 工具劫持。攻击者通过提示词操纵等,篡改工具使用优先级,欺骗智能体选择错误工具。
(7) 资源过载。智能体调用工具过程中,未合理设置调用轮次、并发频次等,出现循环重复调用、批量过量请求等行为,引发资源超载或异常耗尽。
6. 记忆存储风险
(1) 记忆留存不当。长期记忆存储未采取加密、隔离等安全措施,造成敏感数据泄露等。
(2) 记忆失真。由于记忆压缩、更新或合并不规范,导致记忆信息丢失、语义偏移或错误记忆固化,引发智能体决策错误。
(3) 记忆污染。智能体将恶意指令、错误信息等内容写入长期记忆,持续影响后续决策。
(4) 记忆窃取。智能体长期记忆被越权访问,导致特定敏感信息泄露,或重要数据被窃取。
7. 结果输出风险
(1) 敏感违法信息内容输出。智能体输出违法不良信息、敏感个人信息,或虚假错误、偏见歧视等内容,破坏网络生态、泄露敏感信息,甚至危害民众身心健康。
(2) 实施恶意行为。智能体执行结果可能存在攻击行为,导致系统被破坏、用户权益受损或违反内容合规要求。
8. 停用下线风险
(1) 服务残留。智能体停用后,进程、端口、网络连接等未被终止或卸载不规范,仍在后台执行读写数据、请求网络等非预期行为。
(2) 权限与凭证遗留。智能体停用后,对应的服务账号、接口访问权限等未被及时禁用或撤销,可能被攻击者利用,造成资源盗用或数据泄露等后果。
(3) 数据留存不当。智能体运行期间产生的日志、配置、审计资料及用户数据等,未按要求进行归档或清理,增加数据泄露风险。
9. 其他安全风险
(1) 通信协议安全风险。智能体在与模型、工具以及其他智能体通信时使用了不安全的协议或认证方法,导致数据和指令泄露。
(2) 日志缺失。智能体缺少必要的日志留存功能,导致发生安全事件时无法有效追溯。
(3) 行为逃逸。智能体利用运行环境漏洞或配置缺陷,突破安全限制,造成行为不可控。
(4) 系统权限滥用。智能体获取非必要的系统权限,或攻击者利用系统漏洞将低权限账户提升为高权限账户,造成过度授权、非法操作等。
(5) 技能管理不当。技能配置不规范、校验机制缺失等,引发误用滥用、系统异常等安全问题。
(6) 超范围使用数据。智能体过度收集数据,或将采集或生成的数据用于用户未授权的其他目的,导致隐私泄露、数据侵权等。
二、防范措施
1. 风险预防前置
在智能体投入使用之前,通过前瞻性风险评估、制定安全控制策略等,及时排查清除潜在安全隐患,避免智能体安全事件发生或风险扩大。
(1) 安全需求确认。明确智能体的应用场景、业务流程、可访问资源和禁止性行为,分析研判潜在威胁与安全需求,制定安全风险台账并持续更新。
(2) 安全风险分级。根据智能体可能影响的客体类别、影响程度、范围和可恢复性,划分智能体操作安全风险级别。
(3) 安全控制策略。选用可靠的安装物料,根据部署方式实施环境隔离与网络分段,制定动态安全控制策略与应急响应流程,实施分阶段渐进式部署,逐步增加智能体访问权限和自主性。
(4) 安全机制确认。对智能体及选用的大模型进行安全测试和评估,及时处置安全隐患,并保留版本发布与回退记录。
2. 身份与权限管理
为智能体配备唯一身份标识及对应的身份凭证,按需分配任务权限,强化各类访问凭证管理。
(1) 身份管理。为智能体配备唯一身份标识,禁止智能体应用实例间共享身份标识。鉴别用户、智能体、工具及外部服务身份,确保访问主体身份可信。
(2) 权限管理。明确仅限用户本人决策、需由用户授权决策和智能体自主决策等各种决策方式的合理边界及所需权限。仅为智能体授予执行当前任务所必需的最小权限,不过度授予权限。
(3) 凭证管理。使用标准化的动态授权凭证,确保不同相关方之间可互认互通,并对凭证进行隔离管理。凭证接收方严格校验凭证载明的授权范围,超出时触发拦截预警。当任务终止或智能体停用后,立即撤销对应凭证。
3. 加强人工审批
在关键决策节点设置强制人工审批环节,防范高风险操作。
(1) 风险分级控制。基于智能体风险级别提供对应的操作控制。制定高风险操作清单,智能体在执行高风险操作前,将操作转交用户接管;在执行中低风险操作前,需获得用户的授权。
(2) 设置人工控制节点。在智能体工作流的必要环节实施人工控制,确保人类能够随时审核、变更、中断智能体运行。对删除文件、发送数据、修改系统配置等重要操作进行二次确认或人工审批,并提供回滚、撤销等功能。
(3) 留存人工审批日志。采用防篡改、可校验的方式保存人工审批记录,防止日志数据被篡改、删除或覆盖,并按要求确定留存期限。
(4) 人工审批异常处理。当人工审批系统出现异常或用户无响应、缺乏对应人工审批规则时,默认拒绝操作执行,避免操作越界。
4. 供应链与工具管理
智能体依赖的工具、插件、技能等需经过安全性与完整性验证,防止非预期行为和供应链投毒风险。
(1) 工具调用管理。智能体在调用工具之前,检查工具的版本信息、描述文件、参数定义、元数据信息,不调用公开已知的恶意工具。
(2) 公平调用工具。智能体选择工具时,遵循公正原则,基于任务需求和工具能力合理选择。
(3) 工具异常检测。智能体对工具执行逻辑、调用结果进行检测,当检测到异常偏离时,采取告警、阻断等措施。
(4) 工具运维管理。建立工具动态管理机制,及时清理不再使用、权限过高、长期闲置或存在安全隐患的工具。
(5) 技能管理。优先使用来源可靠、经过安全测试的技能。未经安全测试的技能,在使用前做好风险防范。
(6) 供应链安全验证。对第三方组件和外部服务开展来源、完整性和版本校验,持续跟踪并及时处置已知漏洞和供应链风险。
5. 运行时动态管理
智能体使用过程中,设置多层检测与拦截点,防范因单个环节出现异常造成严重后果。
(1) 输入管理控制。对不同来源的指令进行分类与优先级控制,校验来源的可信度,发现恶意或违规指令时自动拦截并移交人工复核。
(2) 建立安全护栏。设置任务规划、工具调用和输出结果的安全规则,对高风险或异常行为采取告警、限制、拦截、暂停或终止等措施。
(3) 记忆留存管理。根据处理目的和必要性确定记忆内容、保存期限和访问范围,对不同用户、任务的记忆实施隔离。凭证、密钥原则上不写入记忆;确需在记忆中留存敏感个人信息的,采取加密、访问控制和最短保存期限等专门保护措施。
(4) 通信安全管理。智能体与大模型、工具等通信时,应相互鉴别身份,使用具备完整性、机密性、可用性、抗重放性的安全通信机制。
(5) 自主执行控制。合理设置智能体执行步骤、调用频次、执行时长和资源消耗等参数,对异常循环、目标偏移等情况,及时采取暂停、终止或转人工处理等措施。
(6) 运行环境隔离。对代码执行、工具调用等高风险操作采用沙箱、容器等隔离手段,限制不必要的系统、文件和网络访问权限。
6. 持续监测与审计
开展智能体全链路安全监测,确保智能体的行为可感知、可追溯、可审计。
(1) 异常阻断。实时监控智能体运行状态,当检测到异常情形时,采取告警提示、介入阻断等措施。
(2) 加强数据管理。处理数据应遵循必要原则,仅处理与任务直接相关的数据。将用户数据提供给大模型或第三方工具前,需获取用户同意,并支持用户取消同意。在境内收集、产生的数据应在境内存储,数据跨境传输应符合国家数据安全管理相关规定。
(3) 日志管理。对文件操作、指令执行、网络连接、技能调用、交易支付等行为进行全量日志记录。对涉及的业务数据、个人信息等内容进行脱敏处理,并采取防篡改措施。
(4) 安全审计。配置全链路日志审计策略,支持动态运行监测,对服务运行中的相关操作与处理行为进行记录。
(5) 沙箱环境验证。搭建独立隔离的沙箱运行环境,在智能体正式上线部署前,对其进行封闭测试验证,提前发现智能体的异常执行行为、逻辑缺陷与安全漏洞。
(6) 红队测试。建立常态化红队安全测试机制,系统性挖掘智能体安全漏洞、逻辑缺陷,持续验证智能体访问控制与安全防护能力,迭代优化安全防护策略。
(7) 应急处置预案。制定智能体安全事件应急预案,明确不同等级事件的处置流程、责任主体,按要求处置安全事件和安全隐患。
(8) 重大变更安全验证。大模型、智能体框架、工具、权限或安全策略发生重大变化时,应开展安全影响评估和必要的回归测试。
7. 停用安全管理
建立规范化的下线终止、数据处置、运行环境回收等管控机制,保障智能体下线全过程可管控、可溯源,无遗留隐患。
(1) 全面关停服务。智能体下线时应全面终止主程序、关联的后台服务,以及所有配套的进程,逐项核验进程状态、运行端口及网络连接,并撤销第三方应用授权,取消订阅及自动续费,确保智能体完全退出运行状态。
(2) 备份必要数据。在开展环境清理、资源回收前,对仍需保留的智能体会话记录、系统配置、知识库文件、操作日志等数据进行备份。
(3) 清理部署环境。使用官方卸载程序、重置操作系统、关闭公网访问入口,以及清理工作文件、知识库、插件及技能配置等方式,彻底清除残留文件、数 据、账号凭证等。
智能体的认知智能与行动智能仍处于快速跃升迭代阶段,其新型风险隐 患对网络安全带来持续挑战。智能体的风险管理框架将持续升级完善,为智能 体应用研发者、提供者、使用者提供进一步参考。
附件 3 可信人工智能基本准则
落实《全球人工智能治理倡议》, 遵循 “以人为本、智能向善” 的发展方向,共同防范应对人工智能技术失控风险,促进人工智能技术在世界范围内可信应 用,提出可信人工智能基本准则如下:
- 人类最终控制。在人工智能系统关键环节设置人类控制机制,使最终裁 决权归属人类,通过设计安全控制阈值、设置安全终止开关、预留人工干预有 效窗口等措施,确保人工智能系统能够实现人类预期目标、不会脱离人类监督 运行失控。
- 尊重国家主权。研发设计人工智能产品和提供人工智能服务时,应尊重 所在国主权,严格遵守产品和服务运营所在地的法律,并依法接受监管,不得 借助人工智能产品或服务干涉他国内政、社会制度及社会秩序。应尊重各国数 字主权,各国有权基于国情自主选择数智技术发展路径、合作伙伴及相关产品 和服务,不得胁迫他国选边站队。
- 价值观对齐。将和平、发展、公平、正义、民主、自由的全人类共同价 值深度融入人工智能系统全生命周期。
- 提升系统透明度。推动人工智能系统在功能目标、运行逻辑、模型使用、 数据来源、决策依据等关键环节的必要披露,增强社会公众信任基础。
- 促进可客观验证。研究构建客观、公正、透明的测试与认证机制,推动 人工智能系统的功能、性能、安全特性、决策链条等方面可被技术验证。
- 强化安全防护。在人工智能系统设计和部署过程中,强化风险建模、安 全测试和防护机制建设,进行全生命周期审计与记录,防止系统因模型缺陷、 外部攻击和技术滥用等问题偏离预期目标。
- 前瞻预防应对。通过前瞻性风险识别评估,积极预防和动态监测,加强 应急响应,避免人工智能失控事件发生和扩大。加强模型安全风险评测,推动 评测方法、基准的国际互认。
- 全球协同共治。支持联合国发挥主渠道作用,发挥世界人工智能合作组 织等平台作用,推动多边和多方跨领域协同共治,反对以小圈子治理取代全球 治理,加强面向发展中国家的能力建设,促进各国政府、企业、学术机构与社 会公众形成合力,以多层级、多领域的治理机制推动人工智能健康发展。
致谢
中国网络空间研究院、国家互联网信息办公室数据与技术保障中心、国家计 算机网络应急技术处理协调中心、中国网络空间安全协会、中国电子技术标准化 研究院、北京中关村实验室、上海人工智能实验室、中国科学院信息工程研究所、 中国科学院计算技术研究所、国家工业信息安全发展研究中心、工业和信息化部 电子第五研究所、中国移动通信有限公司研究院、中国电信股份有限公司北京研 究院、清华大学、中国科学技术大学、北京航空航天大学、北京邮电大学、北京 师范大学、北京信息科技大学、华东理工大学、西南政法大学、河南大学、百度 在线网络技术 (北京) 有限公司、杭州安恒信息技术股份有限公司、三六零科技 集团有限公司、满帮集团
Content(英文部分)
Preface
Global innovation in artificial intelligence (AI) technologies has entered a period of unprecedented dynamism. Intelligent technologies characterized by intelligent connectivity, human‑machine collaboration, cross‑sector integration, and joint creation and sharing are releasing tremendous energy, bringing both enormous opportunities and governance challenges.
Over the past year, AI technologies and applications have continued to develop rapidly. Technological breakthroughs made in large AI foundation models in areas such as long‑horizon task planning, long‑context memory, and complex‑task reasoning have continuously expanded AI’s capability boundaries. Meanwhile, the capabilities of agentic Al in task planning, tool use, and cross‑application collaboration have been steadily enhanced. AI applications have become increasingly diverse, with a growing variety of products, such as work assistants, personal assistants, and agent phones. As barriers to entry keep lowering, AI is rapidly advancing from a limited number of specialized scenarios into mainstream public applications. As AI evolves from “answering questions” toward “performing tasks”, it is driving transformation in productivity while also giving rise to new disruptive, cross‑domain, and global security risks: It is significantly enhancing the automation, scalability, and sophistication of cyberattacks, reshaping the traditional landscape of cybersecurity offense and defense; at the same time, as AI becomes increasingly connected to the physical world, security risks originating in cyberspace may propagate into the physical domain. More profoundly, AI has demonstrated a self‑accelerating trend of model and algorithm autonomous learning, optimization, and recursive self‑improvement. Whether the speed and direction of technological evolution may exceed human anticipation and control demands attention and vigilance.
To respond to new trends in AI development, address emerging challenges in safety governance, and explore the right answers to the four questions posed by our times concerning AI, under the guidance of the Cyberspace Administration of China (CAC), the National Technical Committee 260 on Cybersecurity of the Standardization Administration of China organized relevant professional institutions, research institutes, and industry enterprises to develop the AI Safety Governance Framework 3.0, building on the AI Safety Governance Framework 1.0 (2024) and the AI Safety Governance Framework 2.0 (2025). Upholding a people‑centered approach and the principle of developing AI for the positive and for good, the Framework adheres to and implements the guiding principles of strengthening risk awareness as well as ensuring safety, security and controllability. It maintains the core logic of “risk classification, technological countermeasures, and comprehensive governance” , updates risk categories in a manner that keeps pace with the times, and adjusts and optimizes technological countermeasures and comprehensive governance measures, aiming to further build consensus on practices for preventing and addressing AI safety risks.
……
www.smartcity.team